
Najszybszy sposób na działający chatbot z bazą wiedzy to pipeline RAG (retrieval‑augmented generation): przygotowanie dokumentów, ekstrakcja fragmentów, embeddings, indeks w wektorowej bazie danych, retriever i dopiero na końcu model językowy. To podejście, a nie sam wybór LLM, decyduje o tym, czy bot odpowiada trafnie, czy zmyśla.
Zanim zaczniesz pisać prompty czy testować ChatGPT, Gemini albo NotebookLM, potrzebujesz uporządkowanej bazy wiedzy i mechanizmu, który wyciąga z niej właściwy fragment w ułamku sekundy. Bez tego nawet najlepszy model będzie zgadywał.
Pipeline w skrócie:
- Zbierz dokumenty (FAQ, regulaminy, cenniki, instrukcje) i podziel je na fragmenty.
- Zamień fragmenty na embeddings i zapisz w wektorowej bazie danych (vector DB).
- Dodaj retriever, który wyszukuje najbardziej pasujący fragment do pytania.
- Podłącz LLM, który na podstawie znalezionego kontekstu formułuje odpowiedź.
Orientacyjny czas wdrożenia zależy od zakresu. Prosty bot oparty na FAQ da się uruchomić szybko. Pełne rozwiązanie RAG z integracjami, wersjonowaniem treści i testami jakości wymaga kilku tygodni, zależnie od liczby dokumentów i kanałów do obsługi.
Baza wiedzy zmienia nie tylko szybkość odpowiedzi, ale i ich jakość. Model językowy bez dostępu do konkretnych danych firmy odpowiada na podstawie ogólnej wiedzy z treningu, co przy pytaniach o cennik, regulamin zwrotów czy godziny pracy kończy się zgadywaniem. Mechanizm RAG ogranicza to ryzyko, bo zanim model wygeneruje odpowiedź, dostaje fragment realnego dokumentu jako punkt odniesienia. Efekt: mniej wymyślonych faktów, więcej odpowiedzi zgodnych z tym, co firma naprawdę oferuje.
Dla biznesu przekłada się to na konkretne liczby operacyjne, nie tylko na wygodę. Zespół wsparcia przestaje odpowiadać po raz setny na to samo pytanie o czas dostawy, a klient dostaje odpowiedź o trzeciej w nocy zamiast czekać do rana. Analizy wdrożeń chatbotów pokazują, że automatyzacja pierwszej linii kontaktu odciąża konsultantów i skraca czas reakcji na zgłoszenia, które faktycznie wymagają człowieka.
W praktyce baza wiedzy sprawdza się w dwóch różnych kontekstach. Pierwszy to obsługa klienta zewnętrznego: pytania o cennik, dostępność produktu, warunki zwrotu czy status zamówienia. Drugi to wsparcie wewnętrzne: pracownik szuka procedury urlopowej, instrukcji obsługi systemu albo zasad rozliczania delegacji. Oba scenariusze wymagają tego samego fundamentu, czyli dobrze uporządkowanych, aktualnych dokumentów.
Kluczowe wnioski
Działający chatbot z bazą wiedzy wymaga trzech elementów jednocześnie: uporządkowanych danych, architektury RAG z embeddingami i wektorową bazą danych oraz mechanizmu eskalacji do człowieka.
| Punkt | Szczegóły |
|---|---|
| Zacznij od danych, nie od modelu | Uporządkowana baza wiedzy z metadanymi i chunkingiem ma większy wpływ na jakość niż wybór ChatGPT czy Gemini. |
| Stosuj architekturę RAG | Embeddings, vector DB i retriever ograniczają halucynacje i podnoszą trafność odpowiedzi. |
| Aktualizuj bazę regularnie | Automatyczna reindeksacja po zmianie dokumentu zapobiega odpowiedziom opartym na nieaktualnych danych. |
| Zabezpiecz dane od początku | Kontrola dostępu, anonimizacja i szyfrowanie muszą działać zanim baza trafi do produkcji. |
| Wybierz gotową platformę dla szybkiego startu | Fibly pozwala uruchomić chatbota z bazą wiedzy bez programisty, z integracjami kanałów i panelem analitycznym. |
Spis treści
- Planowanie struktury bazy wiedzy: co zebrać i jak uporządkować
- Formatowanie treści pod modele językowe: szablony i dobre praktyki
- Zarządzanie aktualizacjami i wersjonowanie treści
- Gdzie trzymać bazę wiedzy: chmura, lokalnie, opóźnienia i koszty
- Jak połączyć vector DB, retriever i model w architekturze RAG
- Bezpieczeństwo, prywatność i zgodność: co zabezpieczyć obowiązkowo
- Wdrożenie, testowanie i metryki sukcesu
- Praktyczna checklista wdrożenia: kroki od 0 do produkcji
- Przykłady zastosowań i krótkie case'y
- Studium praktyczne: jak wygląda wdrożenie dla małej firmy
- Fibly jako gotowe rozwiązanie dla małych zespołów
- Źródła
- Najczęściej zadawane pytania
Planowanie struktury bazy wiedzy: co zebrać i jak uporządkować
Zanim jakikolwiek dokument trafi do wektorowej bazy danych, musisz wiedzieć, co w ogóle wchodzi w skład bazy wiedzy. Najczęstszy błąd to wrzucenie wszystkiego, co firma kiedykolwiek napisała, bez selekcji i bez struktury.
Typowy zestaw źródeł do zebrania na start wygląda tak:
- FAQ i najczęściej zadawane pytania z działu obsługi klienta.
- Regulaminy, polityki zwrotów i warunki gwarancji.
- Cenniki i opisy pakietów lub usług.
- Instrukcje obsługi i specyfikacje produktów.
- Artykuły z bloga firmowego, jeśli zawierają praktyczne odpowiedzi.
- Historyczne e‑maile ze wsparcia, które pokazują realne pytania klientów.
Każdy z tych dokumentów potrzebuje metadanych, żeby retriever mógł go później sensownie dopasować do pytania. Praktyczny poradnik organizacji bazy wiedzy pod modele takie jak ChatGPT, Gemini czy NotebookLM podkreśla, że sama treść bez kontekstu opisowego szybko traci użyteczność, gdy baza rośnie.
Proponowana taksonomia obejmuje przynajmniej: typ dokumentu (FAQ, regulamin, instrukcja), datę ostatniej aktualizacji, numer wersji, autora lub dział odpowiedzialny, tagi tematyczne oraz powiązane produkty czy usługi. Dzięki temu, gdy zmienia się cennik, wiesz dokładnie, które fragmenty trzeba podmienić, zamiast przeszukiwać cały zbiór ręcznie.
Struktura plików nie musi być skomplikowana, ale musi być spójna. Sprawdza się podział na foldery według działu (sprzedaż, wsparcie, HR, produkt), a w każdym folderze osobne pliki dla różnych typów treści. Fragmentacja dokumentów, czyli chunking, to kolejny krok krytyczny dla jakości odpowiedzi. Zbyt duże fragmenty rozmywają kontekst, zbyt małe tracą sens bez otoczenia. Sprawdzoną praktyką jest dzielenie tekstu na fragmenty od 200 do 500 słów, z zachowaniem nagłówka sekcji jako kontekstu dołączonego do każdego fragmentu.
Oczyszczanie materiałów to etap, który najczęściej się pomija, a który ma ogromny wpływ na jakość wyszukiwania. Menu nawigacyjne, stopki, numery stron, powtarzające się nagłówki i przypisy prawne trafiające razem z treścią zaśmiecają embeddings i obniżają trafność wyników. Normalizacja formatu, czyli sprowadzenie wszystkiego do czystego tekstu lub Markdown, ułatwia dalsze przetwarzanie i zmniejsza ryzyko błędów podczas ekstrakcji.
Porada profesjonalisty: Zanim zaimportujesz cały katalog dokumentów, przetestuj proces na dwudziestu, trzydziestu plikach. Sprawdzisz wtedy, czy Twoje reguły chunkingu i tagowania w ogóle działają, zanim zainwestujesz czas w tysiące stron.
Formatowanie treści pod modele językowe: szablony i dobre praktyki
Model językowy nie czyta dokumentu tak jak człowiek. Szuka fragmentu, który semantycznie pasuje do pytania, a potem próbuje sklecić z niego odpowiedź. Im wyraźniejsza struktura tekstu, tym mniejsze ryzyko, że bot połączy dwa niepowiązane fakty w jedną fałszywą odpowiedź.
Najlepiej sprawdzają się dwa szablony. Pierwszy to prosty układ pytanie, krótki kontekst, precyzyjna odpowiedź: pytanie w jednym zdaniu, jedno lub dwa zdania tła, a potem konkretna, jednoznaczna odpowiedź bez dygresji. Drugi szablon, przydatny przy dłuższych treściach jak regulaminy, to nagłówek, krótkie streszczenie, a potem szczegóły w punktach.
Zamiana artykułu na zestaw danych gotowych do embeddingu wygląda na przykładzie regulaminu zwrotów tak:
- Wyodrębnij pytanie, które klient realnie zadałby (np. „Ile mam czasu na zwrot towaru?”).
- Skróć odpowiedź do jednego, precyzyjnego akapitu bez odwołań do innych sekcji regulaminu.
- Dodaj metadane: kategoria „zwroty”, data aktualizacji, powiązany produkt jeśli dotyczy.
- Zapisz jako osobny fragment, nie jako część większego dokumentu.
Kilka zasad formatowania, o których warto pamiętać przy przygotowaniu treści:
- Unikaj skanów i zrzutów ekranu z tekstem. Model nie odczyta ich bez dodatkowego OCR, a jakość takiego odczytu bywa niska.
- Oddzielaj tabele danych (np. cenniki) od opisowych metadanych. Tabela wrzucona razem z akapitem tekstu psuje strukturę embeddingu.
- Preferuj Markdown, HTML lub czysty tekst zamiast PDF‑ów jako jedynego formatu źródłowego.
- Oznacz pola krytyczne, takie jak ceny, terminy czy warunki gwarancji, wyraźnym nagłówkiem sekcji, żeby retriever traktował je priorytetowo.
Dokumentacja funkcji bazy wiedzy w narzędziach do obsługi klienta pokazuje podobny wzorzec: krótkie, samodzielne wpisy działają lepiej niż długie artykuły, bo łatwiej je dopasować do pojedynczego pytania użytkownika. Warto też pamiętać, że oznaczenie ważnych pól nie polega na pogrubieniu tekstu, tylko na strukturze nagłówków i osobnych fragmentach. Pogrubienie widzi człowiek, ale retriever operuje na całych blokach tekstu, nie na formatowaniu wizualnym.
Zarządzanie aktualizacjami i wersjonowanie treści
Baza wiedzy, która nie jest aktualizowana, psuje się szybciej niż jakikolwiek inny element systemu. Cennik sprzed pół roku, nieaktualny regulamin czy stara wersja instrukcji prowadzą wprost do błędnych odpowiedzi bota, nawet jeśli sam model działa bez zarzutu.
Proces aktualizacji warto zorganizować w czterech krokach:
- Przyjęcie zgłoszenia zmiany (nowy cennik, zmieniony regulamin, nowa instrukcja).
- Walidacja merytoryczna przez osobę odpowiedzialną za dany obszar.
- Automatyczne czyszczenie i normalizacja nowego dokumentu.
- Ponowny chunking i reindeksacja w wektorowej bazie danych.
Wersjonowanie można prowadzić na dwa sposoby. Wersje semantyczne dokumentów oznaczają numer i datę każdej zmiany treści, co ułatwia śledzenie historii pojedynczego pliku. Pełne snapshoty indeksu vector DB to zrzut całej bazy w danym momencie, przydatny, gdy trzeba szybko wrócić do stanu sprzed awarii.
Kilka mechanizmów automatyzacji, które oszczędzają czas zespołu:
- Webhooki uruchamiające reindeksację natychmiast po zmianie pliku w repozytorium dokumentów.
- Harmonogram cyklicznej reindeksacji, np. raz na tydzień, dla treści rzadziej aktualizowanych.
- Monitoring trafności odpowiedzi, który wykrywa spadek jakości i sygnalizuje potrzebę przeglądu danych.
Rollback jest konieczny, gdy nowa wersja dokumentu wprowadza błędne dane albo gdy reindeksacja psuje jakość odpowiedzi dla całej kategorii pytań. W takiej sytuacji przywracasz poprzedni snapshot vector DB i dopiero po naprawieniu źródła wprowadzasz zmianę ponownie, zamiast łatać błąd na żywym systemie.
Gdzie trzymać bazę wiedzy: chmura, lokalnie, opóźnienia i koszty
Wektorowa baza danych przechowuje embeddings, czyli liczbowe reprezentacje znaczenia tekstu, i pozwala błyskawicznie znaleźć fragmenty najbliższe znaczeniowo pytaniu użytkownika. Bez niej retriever musiałby przeszukiwać cały zbiór dokumentów od zera przy każdym pytaniu, co byłoby zarówno wolne, jak i kosztowne.
Wybór między rozwiązaniem hostowanym a self‑hosted zależy głównie od skali i zasobów zespołu. Hostowana vector DB oznacza mniej pracy operacyjnej: dostawca zarządza infrastrukturą, skalowaniem i kopiami zapasowymi. Dokumentacja usług chmurowych Microsoft Azure pokazuje typowy zakres takich usług, od hostingu baz wektorowych po zarządzanie modelami. Self‑hosted daje więcej kontroli nad danymi i bywa tańszy przy dużej skali zapytań, ale wymaga zespołu, który ogarnie utrzymanie serwerów i monitoring wydajności.
| Kryterium | Hostowana vector DB | Self‑hosted vector DB |
|---|---|---|
| Nakład pracy operacyjnej | Niski, dostawca zarządza infrastrukturą | Wysoki, wymaga własnego zespołu |
| Kontrola nad danymi | Ograniczona umową z dostawcą | Pełna, dane pozostają na własnej infrastrukturze |
| Koszty przy małej skali | Zwykle niższe na start | Wyższe ze względu na koszty utrzymania serwera |
| Koszty przy dużej skali | Rosną wraz z liczbą zapytań | Mogą być niższe dzięki własnej infrastrukturze |
Opóźnienia mają bezpośredni wpływ na to, jak naturalna wydaje się rozmowa z botem. Każdy dodatkowy krok, sieciowy skok między retrieverem a modelem, zapytanie do zewnętrznego API, dokłada milisekundy, które w sumie robią różnicę. Dwa sprawdzone sposoby na ograniczenie tego problemu to lokalne cachowanie najczęściej zadawanych pytań oraz umieszczenie vector DB możliwie blisko instancji modelu językowego pod względem sieciowym.
Koszty operacyjne rozkładają się na trzy główne elementy: przechowywanie embeddingów (rośnie wraz z liczbą dokumentów), zapytania do retrievera (rosną wraz z liczbą interakcji użytkowników) oraz koszty wywołań API modelu językowego. W praktyce to trzeci element bywa najbardziej zmienny, bo zależy od długości promptów i liczby tokenów zwracanych w odpowiedzi. Dyskusje techniczne na temat budowy lokalnych rozwiązań RAG pokazują, że część zespołów decyduje się na lokalne modele właśnie po to, by uniezależnić koszty od liczby zapytań do zewnętrznego API.
Jak połączyć vector DB, retriever i model w architekturze RAG
Architektura RAG składa się z kilku komponentów działających w ściśle określonej kolejności: ingestion dokumentów, generowanie embeddingów, zapis w vector DB, wyszukiwanie przez retriever, złożenie promptu i dopiero na końcu wygenerowanie odpowiedzi przez model. Praktyczny opis takiego pipeline'u pokazuje, że u większości dostawców proces wygląda niemal identycznie, niezależnie od tego, czy na końcu stoi ChatGPT, Gemini czy inny model.
Krok po kroku wygląda to tak:
- Dokumenty trafiają do systemu i przechodzą oczyszczanie oraz chunking.
- Każdy fragment zamieniany jest na wektor liczbowy (embedding).
- Wektory trafiają do indeksu w wektorowej bazie danych.
- Pytanie użytkownika też zamieniane jest na embedding i porównywane z indeksem.
- Retriever zwraca kilka najbardziej pasujących fragmentów.
- System składa prompt z pytaniem i znalezionym kontekstem.
- Model językowy generuje odpowiedź na podstawie tego kontekstu.
Konfiguracja retrievera decyduje o tym, czy bot znajdzie właściwy fragment, czy zgubi się w podobnych, ale nietrafnych treściach. Wyszukiwanie podobieństwa (similarity search) porównuje wektory pod względem odległości matematycznej, natomiast semantyczny ranking dodatkowo waży wyniki według kontekstu całej rozmowy, nie tylko pojedynczego pytania. Połączenie obu metod zwykle daje lepsze rezultaty niż poleganie wyłącznie na jednej z nich.
Projektowanie promptu ma równie duże znaczenie co sama baza danych. Dobra praktyka to dołączanie cytatu źródłowego do każdej odpowiedzi, żeby użytkownik (i zespół wsparcia) mógł zweryfikować, skąd pochodzi informacja. Limit tokenów wymusza selekcję: nie da się wcisnąć całego dokumentu do promptu, dlatego retriever musi zwracać tylko najbardziej trafne fragmenty, zwykle od trzech do pięciu. Strategia kilku przykładów w prompcie (few‑shot) pomaga modelowi zrozumieć oczekiwany format odpowiedzi, szczególnie przy pytaniach wymagających precyzyjnej struktury, jak podanie ceny czy terminu.
Przy integracji z ChatGPT, Gemini czy NotebookLM warto pamiętać o limitach API, w tym limitach liczby zapytań na minutę (rate limits). Każdy z tych dostawców inaczej rozlicza koszty i inaczej reaguje na przekroczenie limitów, dlatego mechanizm ponawiania zapytań (retry) z odpowiednim opóźnieniem powinien być częścią architektury od samego początku, nie dodatkiem wprowadzanym po pierwszej awarii.
Porada profesjonalisty: Zawsze zwracaj w odpowiedzi bota informację, z którego dokumentu i z jakiej daty pochodzi dana informacja. To najszybszy sposób na wykrycie, że baza wiedzy wymaga aktualizacji, zanim klient zdąży się poskarżyć.
Bezpieczeństwo, prywatność i zgodność: co zabezpieczyć obowiązkowo
Baza wiedzy zawiera często dane, których nie chcesz udostępniać każdemu, kto zada odpowiednie pytanie botowi. Kontrola dostępu do samej bazy i do warstwy retrievera powinna działać na poziomie ról: inny zakres widoczności dla klienta zewnętrznego, inny dla pracownika działu sprzedaży, jeszcze inny dla administratora systemu.
Dokumenty trafiające do indeksu warto przejrzeć pod kątem danych osobowych przed samą indeksacją, nie po niej. Usunięcie numerów telefonów, adresów e‑mail czy danych klientów z treści źródłowych zmniejsza ryzyko, że takie informacje pojawią się przypadkowo w odpowiedzi bota skierowanej do innej osoby. Analiza prawnych aspektów wdrażania chatbotów AI w biznesie podkreśla, że automatyzacja tego procesu ogranicza ryzyko błędu ludzkiego znacznie skuteczniej niż ręczna weryfikacja pojedynczych plików.
Checklista podstawowych zabezpieczeń obejmuje:
- Szyfrowanie danych w spoczynku i podczas przesyłu między komponentami systemu.
- Rozdzielenie środowisk deweloperskiego, testowego i produkcyjnego, żeby testy nie dotykały realnych danych klientów.
- Ustalone zasady retencji logów zapytań, z jasnym terminem usuwania starszych wpisów.
- Regularny audyt dostępu do bazy wiedzy i logów rozmów.
Wzorce dobrych praktyk warto czerpać z gotowych dokumentów branżowych. Polityka prywatności dużych dostawców chmurowych pokazuje, jak opisać zasady przetwarzania danych w sposób zrozumiały i zgodny z oczekiwaniami regulatorów.
Porada profesjonalisty: Ustaw automatyczne oznaczanie odpowiedzi bota jako „niepewne”, gdy trafność dopasowania fragmentu spada poniżej ustalonego progu. Taka odpowiedź powinna od razu proponować kontakt z człowiekiem, zamiast zgadywać.
Wdrożenie, testowanie i metryki sukcesu
Bez mierzenia wyników trudno stwierdzić, czy chatbot faktycznie odciąża zespół, czy tylko przenosi frustrację klientów na inny kanał. Kluczowe wskaźniki warto śledzić od pierwszego dnia produkcji, nie dopiero po miesiącu działania.
Najważniejsze metryki do monitorowania:
- Trafność odpowiedzi względem dokumentów źródłowych.
- Odsetek rozmów eskalowanych do konsultanta.
- Średni czas obsługi zapytania od pytania do rozwiązania.
- Satysfakcja klienta (CSAT) mierzona po zakończonej rozmowie.
- Redukcja kosztów obsługi w porównaniu do okresu sprzed wdrożenia bota.
Plan testów przed uruchomieniem produkcyjnym powinien obejmować kilka etapów:
- Testy scenariuszy typowych pytań użytkowników, oparte na realnej historii zgłoszeń.
- Testy parafraz, czyli te same pytania zadane innymi słowami, żeby sprawdzić odporność retrievera na różne sformułowania.
- Testy obciążeniowe sprawdzające zachowanie systemu przy dużej liczbie równoczesnych zapytań.
- Analiza rozbieżności między odpowiedzią bota a treścią dokumentu źródłowego.
Metody ewaluacji jakości warto łączyć. Próbkowanie z udziałem człowieka (human‑in‑the‑loop) polega na regularnym przeglądzie losowych rozmów przez zespół merytoryczny. Testy A/B pozwalają porównać dwie wersje promptu albo dwie konfiguracje retrievera na realnym ruchu. Raportowanie zwrotu z inwestycji najlepiej opierać na konkretnym zestawieniu: liczba zapytań obsłużonych automatycznie pomnożona przez średni koszt obsługi ręcznej, zestawiona z kosztem utrzymania systemu.
Praktyczna checklista wdrożenia: kroki od 0 do produkcji
Poniższy plan prowadzi od pustego folderu z dokumentami do działającego bota w produkcji.
- Audyt dokumentów (2 do 3 dni): zbierz wszystkie źródła, oceń ich aktualność i kompletność.
- Przygotowanie danych (3 do 5 dni): oczyść, sformatuj i podziel dokumenty na fragmenty.
- Budowa embeddingów i indeksu (1 do 2 dni): wygeneruj wektory i załaduj je do vector DB.
- Konfiguracja retrievera (2 do 3 dni): ustaw parametry wyszukiwania i próg trafności.
- Integracja z modelem językowym (3 do 5 dni): połącz retriever z ChatGPT, Gemini lub innym LLM i zaprojektuj prompt.
- Testy wewnętrzne (3 do 5 dni): sprawdź scenariusze, parafrazy i obciążenie.
- Wdrożenie produkcyjne z monitoringiem (1 dzień plus ciągła obserwacja): uruchom bota na wybranym kanale.
Dla prostego MVP opartego na FAQ ten proces da się skrócić do około dwóch tygodni, pomijając część kroków związanych z zaawansowaną konfiguracją retrievera. Przed uruchomieniem sprawdź koniecznie: czy działa mechanizm eskalacji do człowieka, czy bot jasno komunikuje swoje ograniczenia, czy logi zapytań są zabezpieczone i czy masz plan awaryjny na wypadek błędnych odpowiedzi.
Przykłady zastosowań i krótkie case'y
Chatbot z bazą wiedzy sprawdza się w kilku powtarzalnych scenariuszach, choć każdy z nich wymaga innego zestawu dokumentów i innych metryk sukcesu.
- Obsługa klienta e‑commerce: baza obejmuje status zamówień, politykę zwrotów i cenniki dostawy. Kluczowy KPI to odsetek rozmów zakończonych bez udziału konsultanta. Typowe wyzwanie: częste zmiany w promocjach wymagają szybkiej aktualizacji.
- Pomoc techniczna: baza to instrukcje, specyfikacje i historia zgłoszeń. KPI to czas do pierwszej trafnej odpowiedzi. Wyzwanie: pytania bywają bardzo szczegółowe i wymagają precyzyjnego dopasowania fragmentu.
- Wsparcie wewnętrzne pracowników: baza obejmuje procedury HR, instrukcje systemowe i regulaminy wewnętrzne. KPI to redukcja liczby pytań kierowanych bezpośrednio do działu HR.
- Kwalifikacja leadów sprzedażowych: baza to opisy produktów i typowe pytania przed zakupem. KPI to liczba rozmów przekazanych do handlowca z kompletem informacji.
Dla małej firmy priorytetem powinno być pierwsze wdrożenie tam, gdzie liczba powtarzalnych pytań jest największa, zwykle w obsłudze klienta. Przegląd narzędzi do budowy baz wiedzy AI pokazuje, że najczęściej to właśnie ten obszar generuje najszybszy zwrot z inwestycji.
Studium praktyczne: jak wygląda wdrożenie dla małej firmy
Wdrożenie chatbota opartego na bazie wiedzy w małej firmie zwykle zaczyna się od importu istniejących dokumentów, a nie od pisania czegokolwiek od zera. Proces obejmuje trzy główne etapy: integrację bazy wiedzy, konfigurację tonu odpowiedzi dopasowanego do marki oraz ustawienie zasad przekazywania rozmowy do człowieka, gdy bot nie jest pewny odpowiedzi.
Największą korzyścią dla małego zespołu jest brak potrzeby angażowania programisty. Zamiast konfigurować pipeline RAG ręcznie, właściciel firmy wgrywa dokumenty, a system sam je przetwarza i indeksuje. Integracje z kanałami takimi jak WhatsApp, Messenger czy poczta e‑mail pozwalają obsługiwać klientów tam, gdzie faktycznie piszą, bez budowania osobnego bota dla każdego kanału. Panel analityczny pokazuje, które pytania pojawiają się najczęściej i gdzie bot najczęściej się gubi.
Typowe problemy przy takim wdrożeniu obejmują:
- Błędne odpowiedzi wynikające z nieaktualnych lub sprzecznych dokumentów w bazie.
- Brak kontekstu, gdy pytanie klienta jest zbyt ogólne albo dotyczy tematu spoza zakresu dokumentów.
- Opóźnienia przy dużym ruchu w godzinach szczytu, wymagające dostrojenia konfiguracji.
Każdy z tych problemów da się rozwiązać poprzez przegląd i aktualizację źródeł, a dokumentacja rozwiązywania problemów z błędnymi odpowiedziami bota prowadzi krok po kroku przez diagnozę takich sytuacji.
Porada profesjonalisty: Skonfiguruj eskalację do człowieka nie jako ostateczność, tylko jako standardowy element procesu. Klient, który dostaje jasną informację „przekazuję Cię do konsultanta”, jest bardziej zadowolony niż ten, który dostaje niepewną, wymijającą odpowiedź.
Najważniejsze ostrzeżenia i rekomendacje
Najczęstszy błąd, jaki widuję przy wdrożeniach, to traktowanie chatbota jako pełnego zamiennika zespołu obsługi. To założenie prowadzi wprost do frustracji klientów, gdy bot trafia na pytanie spoza swojego zakresu i próbuje na siłę udzielić odpowiedzi zamiast przekazać sprawę dalej. Dobrze zaprojektowany system wie, kiedy powiedzieć „nie wiem” i skierować rozmowę do człowieka, zamiast zgadywać.
Kolejność priorytetów ma znaczenie większe niż wybór konkretnego modelu językowego. Firmy najpierw powinny uporządkować dane i procesy aktualizacji, a dopiero potem zastanawiać się, czy lepiej sprawdzi się ChatGPT, Gemini czy inne rozwiązanie. Najlepszy model podłączony do bałaganu w dokumentach da gorsze wyniki niż przeciętny model podłączony do czystej, dobrze otagowanej bazy wiedzy.
Praktyczna rada na koniec: monitoring i eskalacja to nie dodatek wprowadzany po fakcie, tylko fundament całego systemu od pierwszego dnia produkcji. Bot bez jasnej ścieżki do człowieka to bot, który prędzej czy później zawiedzie w najgorszym możliwym momencie.
Fibly jako gotowe rozwiązanie dla małych zespołów
Zbudowanie własnego pipeline'u RAG od podstaw wymaga czasu, którego mała firma zwykle nie ma w nadmiarze. Fibly rozwiązuje ten sam problem bez konieczności konfigurowania embeddingów, wektorowej bazy danych czy retrievera ręcznie: wgrywasz dokumenty, a system sam buduje z nich bazę wiedzy gotową do odpowiadania na pytania klientów.
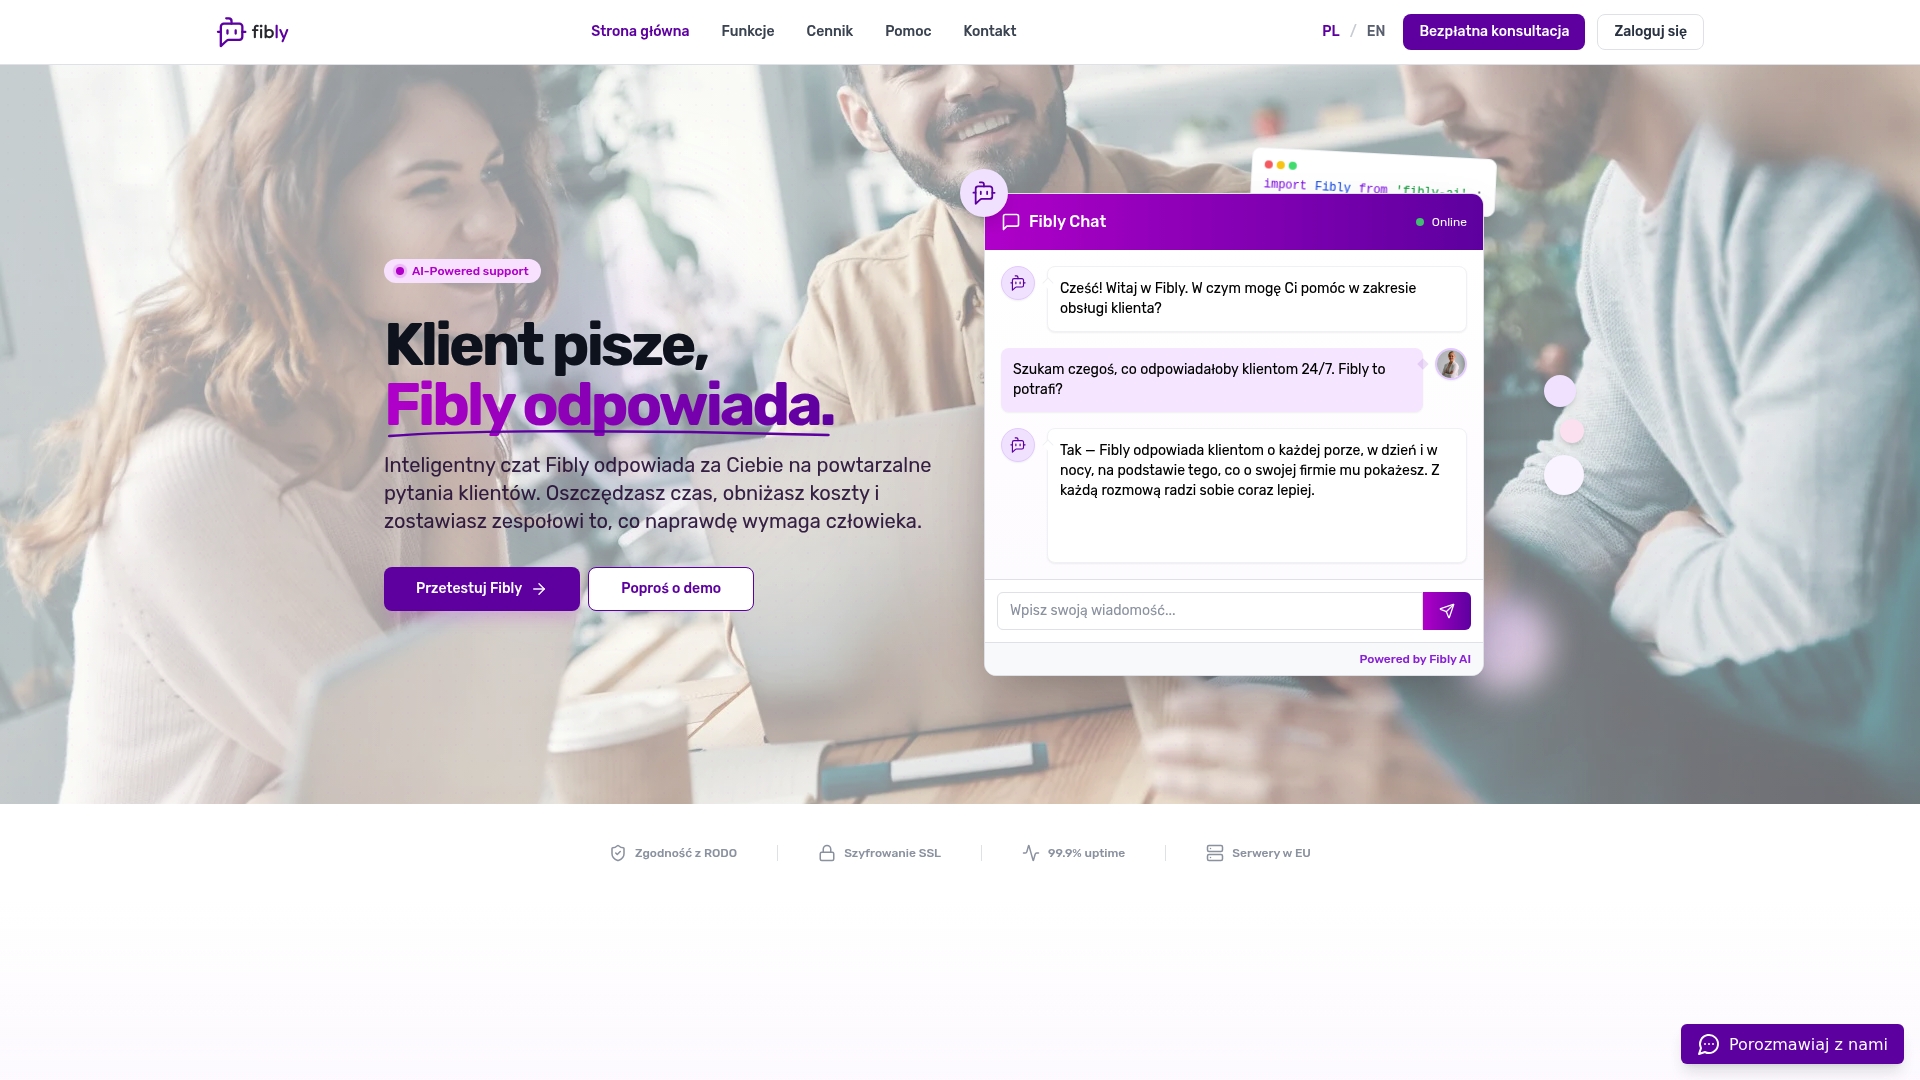
Platforma obsługuje czat na stronie, e‑mail, WhatsApp, Messenger i Instagram z jednego panelu, więc nie musisz budować osobnej integracji dla każdego kanału. Panel analityczny pokazuje, które pytania bot obsługuje samodzielnie, a które wymagają wsparcia człowieka, co ułatwia bieżącą ocenę jakości bez ręcznego przeglądania setek rozmów.
Jeśli chcesz zobaczyć, jak wygląda konfiguracja krok po kroku, przewodnik po działaniu bota i materiały szybkiego startu prowadzą przez cały proces od importu dokumentów do pierwszej rozmowy z klientem. Najprostszy następny krok to sprawdzenie pełnej listy funkcji i uruchomienie własnej bazy wiedzy w koncie testowym.
Źródła
- Chatbot i voicebot — podnoszenie wydajności obsługi klientów | PwC
- Jak zorganizować bazę wiedzy dla AI (ChatGPT, Gemini, NotebookLM) — Cognity
- Microsoft Azure — dokumentacja usług chmurowych
Najczęściej zadawane pytania
Który chatbot z bazą wiedzy jest najlepszy?
Nie ma jednego uniwersalnie najlepszego rozwiązania, bo wybór zależy od skali firmy i zasobów technicznych. Dla małych firm bez zespołu programistów sprawdza się gotowa platforma SaaS jak Fibly, natomiast większe organizacje z własnym zespołem technicznym mogą budować pipeline RAG od podstaw z użyciem ChatGPT, Gemini lub modeli open source.
Czym różni się chatbot z bazą wiedzy od zwykłego chatbota?
Zwykły chatbot opiera odpowiedzi wyłącznie na ogólnej wiedzy modelu z etapu treningu, co zwiększa ryzyko zmyślonych faktów. Chatbot z bazą wiedzy korzysta z mechanizmu RAG, który podłącza konkretne dokumenty firmy jako źródło odpowiedzi.
Jakie są przykłady zastosowań chatbota z bazą wiedzy?
Najczęstsze zastosowania to obsługa klienta w e‑commerce, pomoc techniczna, wsparcie wewnętrzne pracowników i kwalifikacja leadów sprzedażowych. Każde z nich wymaga innego zestawu dokumentów źródłowych, ale mechanizm działania pozostaje ten sam.
Ile czasu zajmuje wdrożenie chatbota z bazą wiedzy?
Prosty bot oparty na FAQ można uruchomić w relatywnie krótkim czasie. Pełne wdrożenie z integracjami, wersjonowaniem treści i testami jakości trwa zwykle kilka tygodni, w zależności od zakresu.
Czy chatbot z bazą wiedzy zastępuje zespół obsługi klienta?
Nie powinien. Najlepsze wdrożenia traktują bota jako pierwszą linię kontaktu, która odpowiada na powtarzalne pytania i przekazuje trudniejsze sprawy do konsultanta, zamiast całkowicie zastępować ludzki zespół.