
O jakości odpowiedzi AI decydują cztery czynniki: trafność, poprawność merytoryczna, kompletność i wierność źródła (faithfulness), nie płynność językowa. Priorytetowe działanie na już: wymuś w odpowiedziach jawne wskazanie źródeł i poziomu pewności albo przełącz nowy model czy prompt w tryb testowy (shadow mode), zanim trafi do klientów. Reszta to kwestia pomiaru, nie zgadywania.
Krótko mówiąc:
- Najważniejsze czynniki jakości odpowiedzi AI to trafność, merytoryczna poprawność, kompletność i wierność źródłu, przy czym płynność językowa nie jest kryterium.
- Warto regularnie aktualizować golden set i przeprowadzać testy regresyjne, aby wykrywać dryf danych i nieaktualne informacje, zanim trafią do klienta.
- Kluczowe jest wymuszenie wskazywania źródeł oraz rozdzielenie faktów od interpretacji, co poprawia wiarygodność i ułatwia wykrywanie halucynacji.
- Odpowiedzialność za błędne informacje spoczywa na firmie, dlatego wprowadzanie AI powinno obejmować podział ról i transparentność wobec klientów.
- Wdrożenie praktyk takich jak shadow mode, monitorowanie wskaźników jakości i feedback od użytkowników zapewnia najefektywniejszy wzrost jakości bez konieczności rozbudowanych działań inżynierskich.
Spis treści
- Wymiary jakości odpowiedzi AI: co dokładnie mierzyć
- Typowe błędy i ryzyka: halucynacje, brak pokrycia źródłowego, dryf danych
- Jak mierzyć jakość odpowiedzi AI: golden set, LLM-as-judge i testy regresyjne
- Praktyczny checklist: jak poprawić jakość odpowiedzi AI krok po kroku
- Monitorowanie jakości odpowiedzi AI w produkcji
- Jakie praktyczne rozwiązania stosuje Fibly, by chronić jakość odpowiedzi
- Znaczenie domeny i kontekstu w ocenie jakości odpowiedzi AI
- Wpływ wielojęzyczności i lokalizacji na jakość odpowiedzi AI
- Rola feedbacku użytkownika w poprawie jakości odpowiedzi AI
- Porównanie jakości odpowiedzi między modelami i architekturami
- Etyczne aspekty jakości odpowiedzi AI
- Perspektywa autora: priorytety, które faktycznie się zwracają
- Fibly jako droga do lepszej jakości odpowiedzi w obsłudze klienta
- Źródła
- Najczęściej zadawane pytania
Wymiary jakości odpowiedzi AI: co dokładnie mierzyć
Jakość odpowiedzi AI w praktyce biznesowej rozkłada się na cztery mierzalne wymiary: trafność, poprawność merytoryczną, kompletność oraz zgodność z instrukcją i tonem marki. W systemach opartych na wyszukiwaniu w bazie wiedzy (RAG) dochodzi piąty, kluczowy wymiar: faithfulness, czyli wierność wobec źródła, z którego odpowiedź została zbudowana.
Każdy z tych wymiarów ma konkretne sygnały ostrzegawcze, które da się rozpoznać bez skomplikowanego narzędzia.
- Trafność – odpowiedź adresuje faktyczną intencję pytania, nie tylko słowa kluczowe z zapytania.
- Poprawność merytoryczna – fakty, liczby i daty zgadzają się ze źródłem, a nie tylko „brzmią” prawdopodobnie.
- Kompletność – odpowiedź nie zostawia klienta z połowiczną informacją, która wymusi kolejne pytanie.
- Zgodność z instrukcją i tonem – model trzyma się polityki firmy (np. nie obiecuje zwrotu pieniędzy, którego regulamin nie przewiduje).
- Faithfulness – każde twierdzenie da się przypisać do konkretnego fragmentu bazy wiedzy, a nie do „wiedzy ogólnej” modelu.
Tu leży najczęstsze nieporozumienie w zespołach produktowych: płynność (fluency) to nie jakość. Model może wygenerować gramatycznie perfekcyjny, elegancki akapit, który jest merytorycznie fałszywy od pierwszego do ostatniego słowa. Fluency ocenia, jak dobrze brzmi tekst. Jakość ocenia, czy tekst jest prawdziwy, kompletny i użyteczny. Rozdzielenie tych dwóch osi to pierwszy krok do sensownej rubryki ocen.
Prosta rubryka do startu wygląda tak: skala 1–5 dla każdego z pięciu wymiarów, z jednym opisem słownym na każdym poziomie („5 – wszystkie fakty potwierdzone w źródle, kompletna odpowiedź”, do „1 – halucynacja lub sprzeczność ze źródłem”). Nie potrzebujesz od razu skomplikowanego systemu punktowego. Potrzebujesz konsekwencji w stosowaniu tej samej rubryki tydzień po tygodniu.
Typowe błędy i ryzyka: halucynacje, brak pokrycia źródłowego, dryf danych
Halucynacje najczęściej pojawiają się tam, gdzie baza wiedzy nie ma odpowiedzi, a model i tak musi coś powiedzieć. Zamiast odpowiedzieć „nie wiem”, duże modele językowe mają tendencję do wypełniania luki prawdopodobną, dobrze sformułowaną treścią, która nie ma pokrycia w rzeczywistości. Mechanizm treningowy, w tym uczenie ze wzmocnieniem na podstawie ludzkich preferencji (RLHF), premiuje odpowiedzi, które brzmią pomocnie i pewnie, nawet gdy pewność nie jest uzasadniona.
Rozpoznanie halucynacji w praktyce sprowadza się do kilku sygnałów ostrzegawczych.
- Konkretna liczba, data lub nazwa produktu podana bez odniesienia do dokumentu źródłowego.
- Stanowcze sformułowania („zawsze”, „gwarantujemy”, „na 100%”) w miejscach, gdzie polityka firmy przewiduje wyjątki.
- Odpowiedź, która brzmi kompletnie, ale odpowiada na inne pytanie niż to zadane.
- Rozbieżność między odpowiedzią z tego samego pytania zadanego dwa razy pod rząd.
Drugie ryzyko, mniej oczywiste, to dryf danych. Baza wiedzy firmy zmienia się: nowy cennik, zmieniona polityka zwrotów, wycofany produkt. Model, który wczoraj odpowiadał poprawnie, dziś może cytować nieaktualną informację, jeśli dokumenty źródłowe nie zostały zaktualizowane albo nie mają metadanych o dacie ważności. To samo dotyczy aktualizacji samego modelu przez dostawcę: zmiana wersji może subtelnie przesunąć styl i pewność odpowiedzi bez ostrzeżenia.
Porada profesjonalisty: Jeśli odpowiedź zawiera liczbę, datę albo nazwę własną, zawsze sprawdź, czy da się ją wskazać jako cytat z konkretnego dokumentu. Jeśli nie da się, to sygnał, że model improwizuje.
Praktyczne procedury weryfikacji, takie jak wymuszanie jawnego wskazania źródła i oddzielanie faktów od interpretacji, znacząco ułatwiają wykrycie tych problemów, zanim trafią do klienta.
Jak mierzyć jakość odpowiedzi AI: golden set, LLM-as-judge i testy regresyjne
Skuteczna ewaluacja jakości odpowiedzi AI łączy dwa poziomy: testy offline przed wdrożeniem i monitoring online po wdrożeniu. Sam zestaw testowy, nawet najlepszy, nie wykryje problemu, który pojawia się tylko na żywych rozmowach klientów, gdy dryf danych zacznie działać po miesiącach stabilnej pracy.
- Zbuduj zestaw referencyjny (golden set). To kolekcja typowych pytań klientów z zatwierdzonymi, poprawnymi odpowiedziami wzorcowymi. Powinien być żywy, nie zamrożony raz na zawsze. Dobra praktyka to dopisywanie co kwartał nowych przypadków z produkcji, na których agent zawiódł, aby testy regresyjne odzwierciedlały aktualne ryzyka, nie tylko te z dnia wdrożenia.
- Uruchom testy regresyjne przy każdej zmianie. Każda modyfikacja promptu, bazy wiedzy lub wersji modelu przechodzi przez cały golden set, zanim trafi na produkcję. To najprostszy sposób wykrycia, że „poprawka” w jednym miejscu zepsuła coś w drugim.
- Zastosuj LLM-as-judge z kalibracją. Model oceniający inny model potrafi skalować ewaluację na tysiące odpowiedzi, ale wymaga wcześniejszej kalibracji względem ocen ludzkich ekspertów i miary zgodności między recenzentami. Bez tego kroku LLM-as-judge powiela własne uprzedzenia, na przykład premiuje dłuższe odpowiedzi niezależnie od treści. Praktyczny przykład takiego workflow, z metrykami typu ROUGE i eksperymentami porównawczymi szablonów promptów, opisuje Google Codelabs.
- Monitoruj wskaźniki produkcyjne na bieżąco. Kluczowe metryki to odsetek odpowiedzi zgodnych ze źródłem (faithfulness), percentyle opóźnień (p95/p99), odsetek eskalacji do człowieka oraz precyzja i pokrycie (precision/recall) przy filtrowaniu odpowiedzi niskiej jakości, przed publikacją.
Zestaw ewaluatorów ręcznych i automatycznych działających równolegle daje najbardziej wiarygodny obraz: automatyczny sprawdza skalę, ręczny sprawdza przypadki graniczne, na których automat sam nie jest pewny.
Praktyczny checklist: jak poprawić jakość odpowiedzi AI krok po kroku
Poprawa jakości odpowiedzi AI zaczyna się od struktury, nie od większego modelu. Zespoły, które osiągają najlepsze wyniki, zmieniają najpierw sposób, w jaki model korzysta z danych, a dopiero potem eksperymentują z samym modelem.
- Wymuś ścieżkę rozumowania i cytowanie źródeł. Poproszony o wskazanie, z którego fragmentu bazy wiedzy pochodzi odpowiedź, model rzadziej zmyśla, a błędy stają się łatwiejsze do wychwycenia automatycznie.
- Rozdziel format odpowiedzi na fakty i wnioski. Fakt cytowany ze źródła i interpretacja modelu to dwie różne rzeczy, a klient (i twój system kontroli) powinien widzieć różnicę.
- Generuj kilka wariantów i wybieraj najlepszy przed publikacją. Technika rerankingu, w której model tworzy kilka odpowiedzi z tego samego zestawu fragmentów i ocena wybiera najlepszą, zauważalnie poprawia stabilność wyników względem publikowania pierwszej wygenerowanej wersji.
- Zaktualizuj bazę wiedzy z metadanymi. Wersjonowanie dokumentów, daty ważności i tagi kategorii pozwalają modelowi (i ewaluatorowi) odróżnić aktualną politykę od archiwalnej.
- Wprowadź tryb testowy (shadow mode) dla nowych zmian. Nowy prompt, model albo fragment bazy wiedzy generuje odpowiedzi równolegle z produkcją, ale nie wysyła ich do klienta, dopóki nie osiągnie ustalonego progu jakości.
Porada profesjonalisty: Zanim włączysz automatyczną publikację nowej wersji, przepuść ją przez tydzień shadow mode na realnym ruchu. To tańsze niż naprawianie reputacji po serii błędnych odpowiedzi.
Monitorowanie jakości odpowiedzi AI w produkcji
Metryki jakości mają sens dopiero, gdy połączysz je z metrykami biznesowymi. Wysoki wynik faithfulness na testach offline nic nie mówi zarządowi, jeśli nie przełożysz go na język, który rozumie dział operacyjny.
- Odsetek spraw zamkniętych bez eskalacji do konsultanta, powiązany z wynikiem faithfulness z tego samego okresu.
- Czas pierwszej odpowiedzi w rozbiciu na kanały (czat, e-mail, WhatsApp).
- Liczba i charakter incydentów, w których odpowiedź trzeba było poprawić ręcznie po publikacji.
- Wynik testów regresyjnych po każdej zmianie promptu, modelu lub bazy wiedzy, z datą i zakresem zmiany.
Sam test przed wdrożeniem nie wystarczy, bo tylko monitoring na żywo wykrywa dryf danych, który pojawia się tygodnie po starcie. Zbierz to w jednym raporcie dla interesariuszy, na jednej stronie: cztery liczby z ostatniego tygodnia, lista incydentów z krótkim opisem przyczyny, jedna rekomendacja na następny sprint. Zarząd nie potrzebuje wykresu z dziesięcioma liniami. Potrzebuje wiedzieć, czy trend idzie w dobrą stronę i co zrobić, jeśli nie.
Jakie praktyczne rozwiązania stosuje Fibly, by chronić jakość odpowiedzi
Jakość odpowiedzi chatbota Fibly zależy w pierwszej kolejności od jakości bazy wiedzy, z której korzysta. Uporządkowany, aktualny kontekst bazy wiedzy ogranicza ryzyko odpowiedzi bez pokrycia źródłowego, bo model ma mniej powodów do improwizacji.
Dwie funkcje wpisują się bezpośrednio w praktyki opisane wyżej. Asysta AI dla konsultanta proponuje odpowiedź człowiekowi, zamiast automatycznie wysyłać ją do klienta w sprawach o wyższym ryzyku. Możliwość przejmowania rozmowy działa jak ręczny obwód bezpieczeństwa, gdy bot trafia na pytanie poza swoim zakresem kompetencji.
Znaczenie domeny i kontekstu w ocenie jakości odpowiedzi AI
Ta sama metryka faithfulness znaczy coś innego w e-commerce niż w opiece zdrowotnej. Sklep internetowy odpowiadający na pytanie o czas dostawy ma niski koszt błędu: klient zadzwoni ponownie, jeśli odpowiedź się nie zgadza. Odpowiedź o interakcji leków ma koszt błędu nieporównywalnie wyższy, więc próg akceptowalnej niepewności musi być znacznie niższy.
Domena determinuje też, jakie pytania w ogóle trafiają do golden set. Firma prawnicza priorytetyzuje precyzję terminologii i brak jednoznacznych deklaracji tam, gdzie prawo przewiduje wyjątki. Firma logistyczna priorytetyzuje aktualność danych liczbowych (statusy przesyłek, terminy) ponad styl językowy. Ten sam model, ta sama architektura, dwa zupełnie różne progi jakości.
Specyfika tematyczna wpływa również na to, które błędy są „ciche”, a które widoczne od razu. W obsłudze klienta e-commerce nieprecyzyjna odpowiedź o zwrotach zostanie wychwycona szybko, bo klient napisze ponownie albo zareklamuje. W dziedzinach specjalistycznych, jak finanse czy zdrowie, błędna odpowiedź może zostać zaakceptowana przez czytelnika bez weryfikacji, właśnie dlatego, że brzmi autorytatywnie. To argument za tym, żeby próg walidacji eksperckiej rósł proporcjonalnie do potencjalnych konsekwencji błędu, nie do częstotliwości pytania.
Wpływ wielojęzyczności i lokalizacji na jakość odpowiedzi AI
Model, który świetnie radzi sobie w języku angielskim, nie gwarantuje tej samej jakości w polskim czy innym języku o mniejszym korpusie treningowym. Modele duże trenowane są głównie na danych angielskojęzycznych, co przekłada się na wyraźnie słabszą trafność i większą skłonność do halucynacji w językach z mniejszą reprezentacją danych.
Lokalizacja to więcej niż tłumaczenie słowa po słowie. Odpowiedź poprawna gramatycznie po polsku może być niezręczna kulturowo, formalna tam, gdzie firma stosuje ton nieformalny, albo odwrotnie. Zgodność z tonem marki, jeden z pięciu wymiarów jakości opisanych wcześniej, jest szczególnie podatna na utratę precyzji przy przełączaniu języków, bo model musi jednocześnie tłumaczyć treść i dopasowywać rejestr.
Praktyczna konsekwencja dla firm działających wielojęzycznie: golden set powinien zawierać odrębne przypadki testowe dla każdego obsługiwanego języka, nie jeden zestaw przetłumaczony automatycznie. Odpowiedź, która zdaje test w języku źródłowym, może zawodzić w tłumaczeniu, bo błąd powstaje nie w rozumowaniu modelu, a w samym procesie przekładu odpowiedzi na inny język.
Rola feedbacku użytkownika w poprawie jakości odpowiedzi AI
Opinia klienta po rozmowie to najgęściejszy sygnał jakości, jaki masz, i większość firm go nie wykorzystuje systematycznie. Prosty przycisk „to było pomocne / to nie było pomocne” po zakończonej rozmowie z chatbotem generuje dane, które golden set nigdy nie przewidzi, bo pochodzą z realnych, nieprzewidywalnych pytań klientów.
Kluczowe jest zamknięcie pętli: negatywny feedback powinien trafiać do przeglądu, a nie tylko do liczby na dashboardzie. Konsultant, który przejmuje rozmowę po niskiej ocenie bota, sprawdza, czy problemem była baza wiedzy (brak informacji), sam model (błędna interpretacja) czy pytanie klienta (niejasne, wieloznaczne). Ta klasyfikacja mówi, co naprawić.
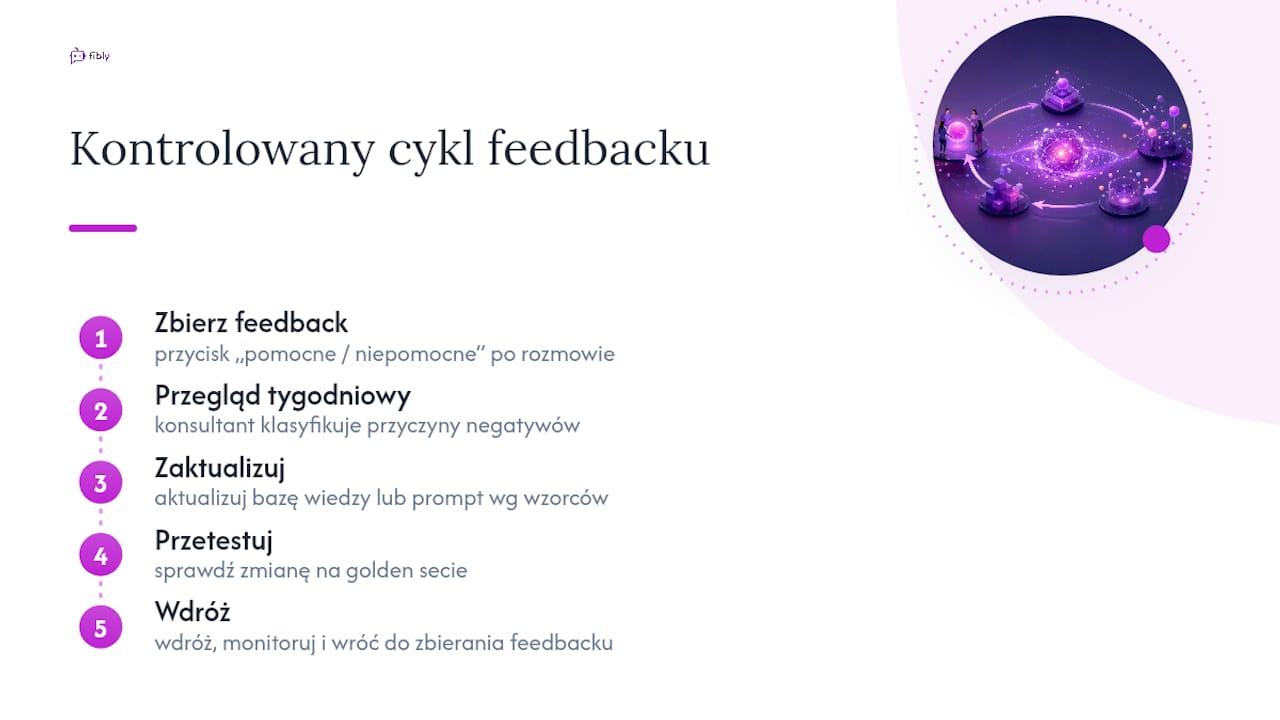
Systemy uczące się na bieżąco, w których feedback automatycznie modyfikuje wagi modelu w czasie rzeczywistym, są rzadkością w praktyce produkcyjnej z powodu ryzyka niekontrolowanego dryfu. Znacznie częstszy i bezpieczniejszy wzorzec to cykl: zbierz feedback, przeglądaj go tygodniowo, aktualizuj bazę wiedzy albo prompt na podstawie wzorców, przetestuj zmianę na golden set, wdróż. To wolniejsze niż uczenie w czasie rzeczywistym, ale dużo łatwiejsze do kontrolowania i audytowania.
Porównanie jakości odpowiedzi między modelami i architekturami
Architektura modelu wpływa na jakość odpowiedzi mniej, niż zakłada popularne przekonanie „większy model znaczy lepszy”. Kluczowe różnice pojawiają się w trzech miejscach: sposobie dostępu do aktualnych danych, długości kontekstu, który model może przetworzyć naraz, i tym, jak został dostrojony (fine-tuned) do konkretnego zastosowania.
Model bez dostępu do zewnętrznej bazy wiedzy (bez architektury RAG) odpowiada wyłącznie na podstawie tego, czego nauczył się podczas treningu. To oznacza nieaktualne informacje o produktach firmy i wyższe ryzyko halucynacji przy pytaniach specyficznych dla danej organizacji. Model połączony z aktualną bazą wiedzy firmy, nawet mniejszy, często odpowiada trafniej na pytania biznesowe niż znacznie większy model bez takiego dostępu.
Długość kontekstu decyduje o tym, ile dokumentów źródłowych model może „widzieć” jednocześnie przy budowaniu odpowiedzi. Krótszy kontekst wymusza agresywniejszą selekcję fragmentów przed wysłaniem ich do modelu, co samo w sobie jest osobnym źródłem błędu, jeśli mechanizm wyszukiwania wybierze niewłaściwy fragment.
Porównywanie modeli wyłącznie na podstawie ogólnych benchmarków (typu wyniki na testach akademickich) mówi niewiele o tym, jak model poradzi sobie z pytaniami konkretnej firmy. Znacznie wiarygodniejszy sygnał dają wyniki na własnym golden set, zbudowanym z realnych pytań klientów danej organizacji.
Etyczne aspekty jakości odpowiedzi AI
Błędna odpowiedź AI to nie tylko problem techniczny, to pytanie o odpowiedzialność. Kiedy chatbot poda klientowi nieprawdziwą informację o warunkach zwrotu albo interakcji leku, odpowiedzialność prawna i reputacyjna spada na firmę, która wdrożyła system, nie na dostawcę modelu.
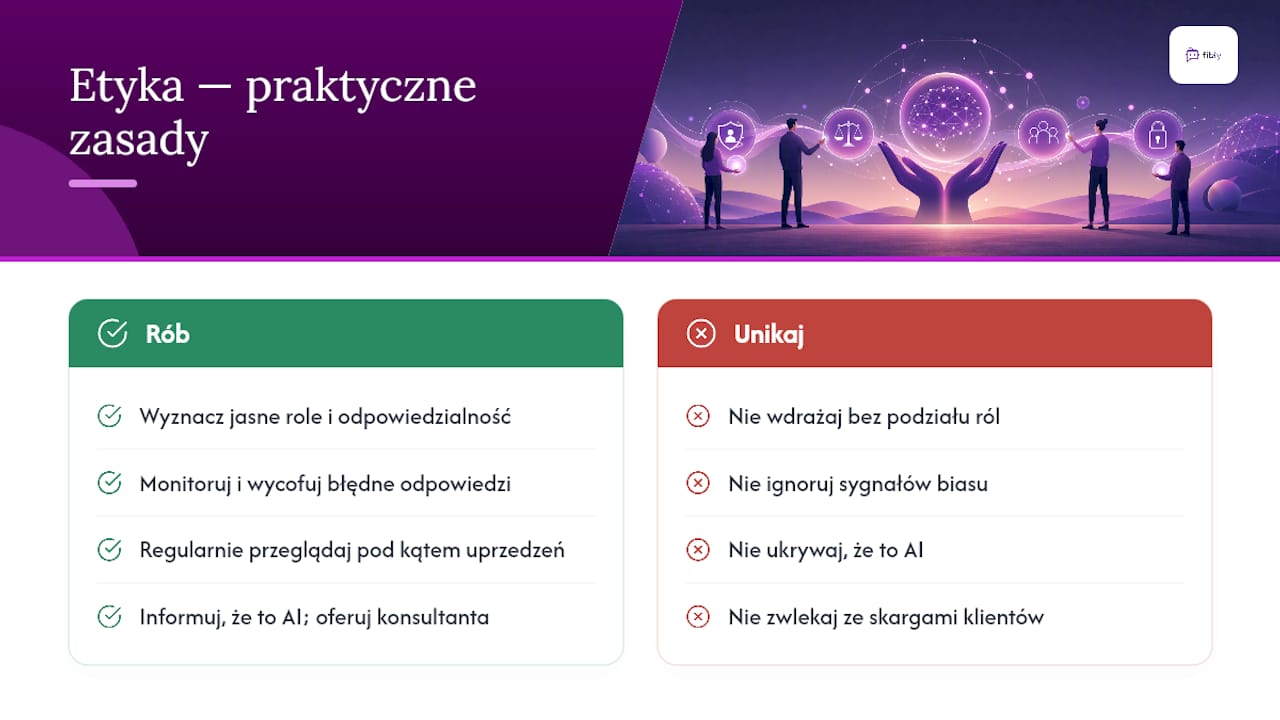
Uprzedzenia (bias) w odpowiedziach AI pojawiają się często niepostrzeżenie, bo model uczy się wzorców z danych treningowych, które same odzwierciedlają istniejące nierówności czy stereotypy. W obsłudze klienta to może oznaczać różne traktowanie zapytań w zależności od stylu pisania klienta, jego imienia czy sposobu formułowania pytania, choć merytoryczna treść zapytania jest identyczna. Regularny przegląd odpowiedzi na podobne pytania sformułowane różnym językiem czy stylem to praktyczny sposób wykrycia takiego wzorca.
Odpowiedzialność za błędne informacje wymaga jasnego podziału ról jeszcze przed wdrożeniem: kto zatwierdza treść bazy wiedzy, kto monitoruje wyniki, kto decyduje o wycofaniu odpowiedzi z produkcji. Firmy, które wdrażają AI bez tego podziału, odkrywają problem dopiero po pierwszej skardze klienta, kiedy jest już za późno na spokojną analizę. Transparentność wobec klienta, na przykład jasna informacja, że rozmawia z asystentem AI i ma możliwość przejścia do konsultanta, to nie tylko dobra praktyka etyczna, ale też praktyczny wentyl bezpieczeństwa dla przypadków, które system źle ocenił.
Perspektywa autora: priorytety, które faktycznie się zwracają
Z całego arsenału technik opisanych wyżej, cztery rzeczy dają najwyższy zwrot z najmniejszym wysiłkiem: żywy golden set aktualizowany kwartalnie, shadow mode dla każdej zmiany zanim trafi do klientów, wymuszanie cytowania źródeł w odpowiedziach oraz monitoring percentyli p95/p99, nie tylko średnich.
Jedna zasada, którą warto zapamiętać: im wyższy koszt błędu dla klienta, tym mniej miejsca na automatyzację bez nadzoru człowieka. Walidacja ekspercka nie jest opcjonalnym luksusem w domenach regulowanych, jest warunkiem odpowiedzialnego wdrożenia.
— Jakub
Fibly jako droga do lepszej jakości odpowiedzi w obsłudze klienta
Wdrożenie wszystkich praktyk opisanych wyżej samodzielnie, od zera, wymaga zespołu inżynierów i miesięcy pracy, a pomocny może być praktyczny przewodnik AI w HR łączący AI z procesami HR. Fibly daje mniejszym firmom skróconą wersję tej samej logiki: aktualna baza wiedzy zamiast ręcznie budowanego systemu RAG, wbudowana asysta AI zamiast osobnego mechanizmu walidacji przed publikacją.
Platforma odpowiada na pytania klientów przez czat na stronie, e-mail, WhatsApp, Messenger i Instagram, ucząc się na bazie wiedzy firmy. Gdy pytanie wykracza poza kompetencje bota, przejmowanie rozmowy przekazuje ją do konsultanta zamiast ryzykować błędną odpowiedź. Asysta AI z kolei wspiera konsultanta gotową propozycją odpowiedzi, którą człowiek zatwierdza albo poprawia, zamiast pisać od zera. To praktyczny odpowiednik shadow mode opisanego wyżej: automat proponuje, człowiek decyduje.
Sprawdź, jak działa bot Fibly i jakie funkcje obejmuje pełna platforma, albo umów demo, żeby zobaczyć, jak wygląda konfiguracja bazy wiedzy dla własnej firmy.
Źródła
- Frontiers in Big Data — artykuł o ewaluacji LLM
- Evaluating single LLM outputs with Vertex AI Evaluation (Codelabs)
- Weryfikacja odpowiedzi AI i ograniczanie halucynacji | Kontrola jakości
Najczęściej zadawane pytania
Czy AI może kłamać w odpowiedziach?
AI nie kłamie w sensie intencji, ale generuje fałszywe treści, gdy nie ma dostępu do prawdziwej informacji i wypełnia lukę prawdopodobną, wiarygodnie brzmiącą odpowiedzią. To zjawisko nazywane halucynacją, a ryzyko ogranicza wymuszanie cytowania źródeł.
Który model AI jest najlepszy dla obsługi klienta?
Nie ma jednego najlepszego modelu w oderwaniu od kontekstu. Ten, który daje wyniki dobre dla konkretnej firmy, to model połączony z aktualną bazą wiedzy tej firmy i sprawdzony na własnym zestawie referencyjnym, nie ten z najwyższym wynikiem na ogólnym benchmarku.
Jak ocenić jakość odpowiedzi generowanych przez AI?
Oceń odpowiedź w pięciu wymiarach: trafność, poprawność merytoryczną, kompletność, zgodność z tonem oraz faithfulness wobec źródła. Połącz testy na zestawie referencyjnym z monitoringiem produkcyjnym, żeby wychwycić błędy niewidoczne w testach statycznych.
Czy sztuczna inteligencja zagraża ludzkości?
To pytanie dotyczy odległych scenariuszy rozwoju technologii, nie bieżącej jakości odpowiedzi chatbotów w firmach. Realne, mierzalne ryzyko dzisiejszych wdrożeń to błędne informacje w konkretnych odpowiedziach, a nie egzystencjalna groźba dla ludzkości, i to właśnie temu ryzyku odpowiadają praktyki opisane w tym artykule.
Czy Fibly weryfikuje odpowiedzi przed wysłaniem do klienta?
Fibly opiera odpowiedzi na bazie wiedzy konkretnej firmy, a funkcja przejmowania rozmowy pozwala konsultantowi wkroczyć w sprawach, których bot nie powinien rozstrzygać samodzielnie.