
Jeśli chatbot daje błędne odpowiedzi, najpierw sprawdź źródło w bazie wiedzy i uruchom zestaw kontrolny probe queries, zanim zaczniesz zmieniać prompty. Błędy w bazie wiedzy prawie nigdy nie wynikają z „głupoty” modelu, tylko z nieaktualnych, sprzecznych albo źle pociętych treści, na których bot się opiera. Ustal, czy problem dotyczy cen, płatności albo polityk (priorytet wysoki) czy raczej drobnego detalu bez wpływu na transakcje, i działaj w tej kolejności.
Krótko mówiąc:
- Nieaktualne informacje, sprzeczne wersje i złe chunkowanie danych są głównymi przyczynami błędów w bazie wiedzy chatbota.
- Weryfikacja pytań testowych i metadanych źródeł powinna zająć maksymalnie 30 minut, skupiając się na krytycznych tematach.
- Aktualizacje bazy i poprawki należy przeprowadzać w sposób uporządkowany, przypisując właścicieli i korzystając z wersjonowania.
- Zarządzanie metadanymi i przypisanie odpowiedzialnych za tematy minimalizuje powrót tych samych błędów.
- Monitorowanie driftu wiedzy i automatyzacja re-indeksacji pozwala na utrzymanie wysokiej jakości odpowiedzi.
Spis treści
- Najczęstsze rodzaje błędów w bazie wiedzy
- Szybka lista diagnozy: co sprawdzić w 15–30 minut
- Jak naprawiać błędy: priorytetyzacja i trwałe procesy
- Zarządzanie treścią: właściciele, metadane i cadence przeglądów
- Testy, monitoring i automatyzacja: jak wykrywać drift wiedzy
- Perspektywa eksperta: typowe pułapki w małych zespołach
- Kiedy warto rozważyć narzędzie do zarządzania bazą wiedzy
- Źródła
- Najczęściej zadawane pytania
Najczęstsze rodzaje błędów w bazie wiedzy
Zanim naprawisz cokolwiek, musisz wiedzieć, z jakim typem błędu w bazie masz do czynienia. Cztery kategorie odpowiadają za większość problemów zgłaszanych przez klientów.
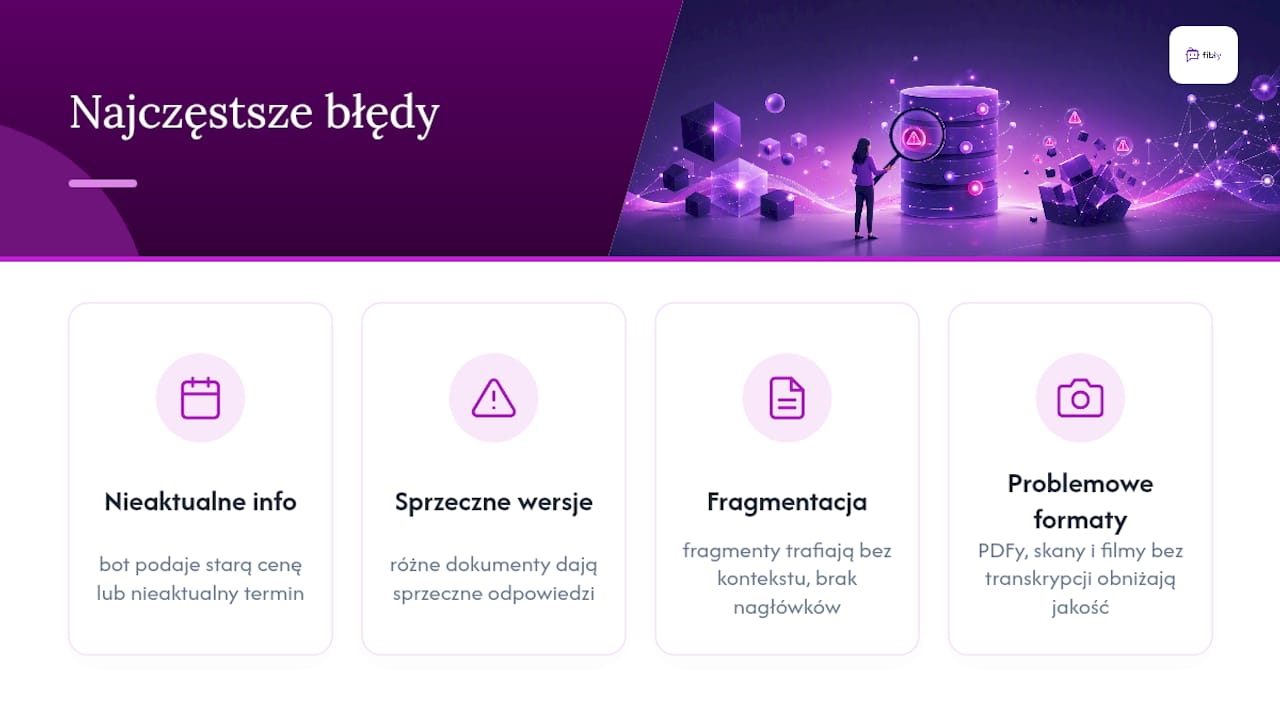
Nieaktualne informacje to najprostszy przypadek: bot podaje starą cenę, nieaktualny termin dostawy albo zasadę reklamacji, którą zmieniliście trzy miesiące temu, a nikt nie zaktualizował dokumentu źródłowego. Rozpoznasz je po tym, że odpowiedź brzmi pewnie, ale klient odpisuje „to nieprawda”.
Sprzeczne wersje powstają, gdy dwa dokumenty w bazie mówią różne rzeczy o tym samym temacie, np. regulamin z 2024 roku i nowszy artykuł FAQ. Bot losowo cytuje jeden albo drugi, więc ten sam klient może dostać dwie różne odpowiedzi w ciągu tygodnia.
Fragmentacja i złe chunkowanie to problem techniczny: fragment tekstu trafia do indeksu bez kontekstu, np. sama tabelka cen bez informacji, do jakiego planu się odnosi. Skuteczny chunk powinien być samodzielny i mieć jasny nagłówek, bo to bezpośrednio poprawia trafność wyszukiwania.
Problematyczne formaty to PDF-y, skany i filmy bez transkrypcji. Model traci przy nich kontekst strukturalny, co realnie obniża jakość odpowiedzi.
Szybka lista diagnozy: co sprawdzić w 15–30 minut
Zanim zaczniesz cokolwiek poprawiać, przejdź przez ten checklist. Zajmie góra pół godziny, a pokaże, gdzie realnie boli.
- Uruchom pięć probe queries z pytań, które klienci zadają najczęściej, i zapisz dokładne odpowiedzi razem z cytowanymi źródłami.
- Sprawdź metadane cytowanych fragmentów — datę ostatniej edycji, właściciela i to, czy dokument nie jest przypadkiem wersją roboczą.
- Poszukaj duplikatów i sprzeczności dla tematów krytycznych: cennik, zwroty, dane kontaktowe, procedury reklamacyjne.
- Zweryfikuj format źródeł — jeśli kluczowa informacja siedzi w PDF-ie albo na obrazku, przekształć ją na tekst możliwy do zaindeksowania.
- Przypisz priorytet na podstawie ryzyka: błędy dotyczące płatności, polityk i bezpieczeństwa naprawiasz od razu, resztę w kolejnym sprincie.
Porada profesjonalisty: Zapisuj każdy probe query i odpowiedź w jednym arkuszu, nawet jeśli wygląda banalnie. Za miesiąc ten arkusz staje się Twoim testem regresji, bez którego nie zauważysz, że nowa aktualizacja zepsuła coś, co wcześniej działało.
Jak naprawiać błędy: priorytetyzacja i trwałe procesy
Największa pułapka to naprawianie objawu promptem, gdy problem siedzi w źródle. Jeśli fragment bazy wiedzy jest błędny, poprawka promptu maskuje go tylko chwilowo. Inspekcja cytowań i poprawa konkretnego fragmentu dają trwalszy efekt niż łatanie promptów, bo kolejna aktualizacja bazy znowu wyciągnie tę samą złą informację.
Modyfikacja promptów albo reguł odmowy ma sens tylko w dwóch sytuacjach: gdy temat jest z natury niepewny (np. porady prawne, których nie chcecie udzielać) albo gdy czekacie na aktualizację źródła i potrzebujecie tymczasowego bezpiecznika.
Sam proces naprawy warto ustandaryzować w czterech krokach:
- Zidentyfikuj konkretny fragment odpowiedzialny za błąd, nie cały dokument.
- Przypisz właściciela tematu, który zna kontekst biznesowy zmiany.
- Popraw treść i metadane (data, status, wersja) w jednym ruchu.
- Wykonaj re-ingest i odpal test regresji na zestawie kontrolnych pytań.
Wersjonowanie i możliwość rollbacku są tu kluczowe. Brak jasnych właścicieli i historii zmian prowadzi wprost do sprzecznych odpowiedzi i halucynacji, bo nikt nie wie, która wersja dokumentu jest aktualna. Ustal proste kryterium akceptacji: zmiana wchodzi do produkcji tylko wtedy, gdy przechodzi test regresji i ma podpis właściciela treści.
Porada profesjonalisty: Nie edytuj fragmentu bazy wiedzy bezpośrednio na produkcji. Trzymaj wersję roboczą, przetestuj ją na probe queries, a dopiero potem publikuj. Pięć minut testu oszczędza tydzień gaszenia pożaru.
Zarządzanie treścią: właściciele, metadane i cadence przeglądów
Błędy w bazie wiedzy wracają, jeśli nikt formalnie nie odpowiada za konkretny temat. Przypisz jednego właściciela na domenę (np. „cennik”, „dostawy”, „reklamacje”), a nie na cały dokument, bo tematy zmieniają się w różnym tempie.
Każdy wpis w bazie powinien mieć minimalny zestaw metadanych:
- Data ostatniego przeglądu i data następnego wymaganego przeglądu.
- Status: aktualny, w edycji, do wycofania.
- Poziom poufności (informacja publiczna vs wewnętrzna).
- Właściciel odpowiedzialny za merytorykę.
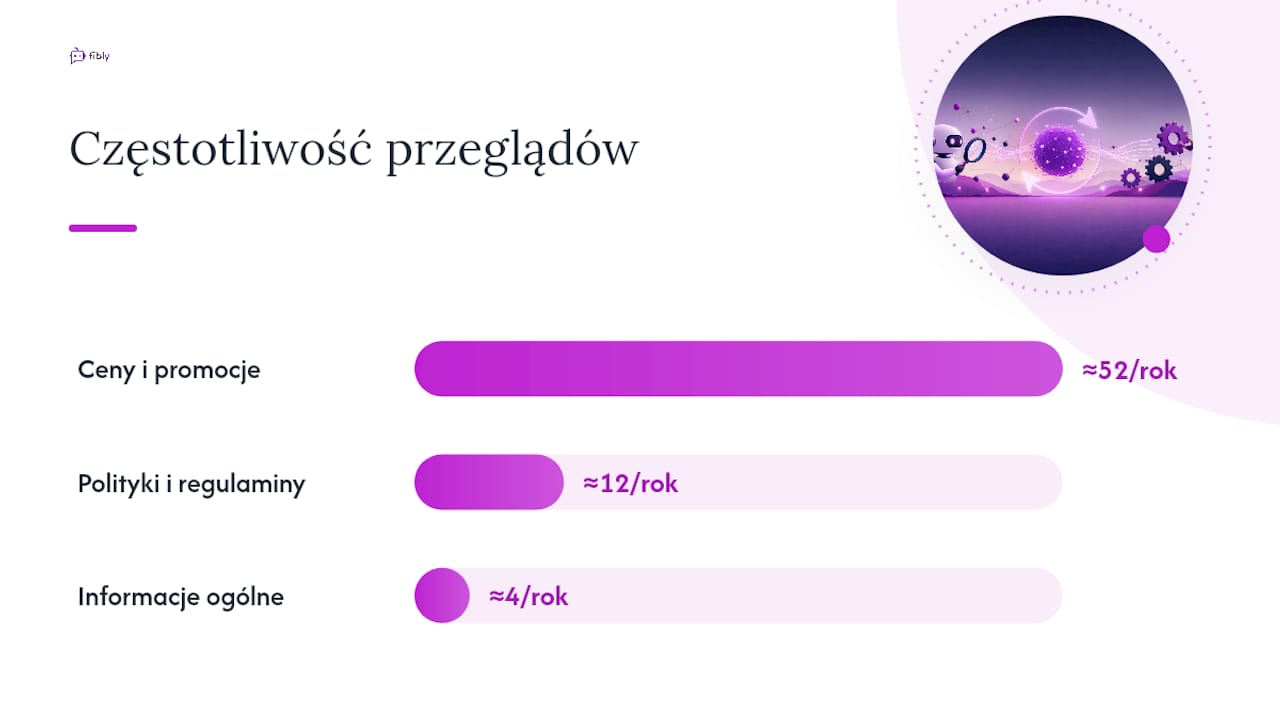
Nie każdy temat wymaga tej samej częstotliwości kontroli. Ceny i promocje sprawdzaj co tydzień, polityki i regulaminy co miesiąc, a informacje ogólne o firmie raz na kwartał. To tzw. tierowanie według zmienności treści.
Ostatni element to zasada kanonizacji: jeden temat, jedno źródło prawdy. Jeśli informacja o zwrotach istnieje w regulaminie, artykule FAQ i mailu do zespołu, wybierz jeden dokument jako oficjalny, a resztę oznacz jako pochodną albo usuń z indeksu. Rejestr źródeł z przypisanymi właścicielami to najprostszy sposób, by to utrzymać w małym zespole bez działu IT.
Testy, monitoring i automatyzacja: jak wykrywać drift wiedzy
Baza wiedzy, która działała idealnie w styczniu, może dawać błędne odpowiedzi w marcu, nawet jeśli nikt jej nie dotknął. To zjawisko nazywa się driftem, i bez monitoringu zauważysz je tylko dzięki skargom klientów.
- Zbuduj zestaw testów regresji z 20 do 50 pytań kontrolnych i odpalaj go po każdej aktualizacji bazy albo modelu.
- Śledź odsetek odpowiedzi bez pokrycia w źródłach oraz liczbę eskalacji do człowieka jako główne sygnały ostrzegawcze.
- Włącz re-ingest automatycznie po każdej edycji dokumentu, żeby indeks nie rozjeżdżał się ze źródłem.
- Podłącz crawlery, kanały RSS albo API dla treści, które zmieniają się poza Waszą kontrolą, np. ceny partnerów.
- Ustal harmonogram re-indexu: natychmiastowy dla zmian krytycznych, cykliczny (np. raz na dobę) dla drobnych aktualizacji.
Inteligentne wykrywanie zmian i re-ingest on edit realnie skracają okno, w którym bot odpowiada na podstawie nieaktualnej wersji dokumentu. Dla zespołów śledzących wiele integracji i logów przydaje się też prosty dziennik zdarzeń w stylu Carozo, który porządkuje historię zmian i ułatwia wracanie do konkretnego momentu diagnozy.
Perspektywa eksperta: typowe pułapki w małych zespołach
Najczęstszy błąd, jaki widzę, to brak jednego właściciela treści i poleganie na PDF-ach jako głównym źródle wiedzy. Firma rośnie, dokumenty się mnożą, a nikt nie ma czasu ich pielić.
Zacznij od dziesięciu najczęściej zadawanych pytań, nie od całej bazy. Przypisz do nich właścicieli i prosty rejestr metadanych w arkuszu, nawet bez żadnego dodatkowego narzędzia. To dziesięć decyzji, nie sto, i można je podjąć w jedno popołudnie.
— Jakub
Kiedy warto rozważyć narzędzie do zarządzania bazą wiedzy
Ręczny audyt i arkusz z metadanymi wystarczą na start, ale gdy baza rośnie, a zespół nie ma czasu na ręczny re-ingest po każdej zmianie cennika, potrzebujecie czegoś, co zrobi to za Was. Istnieją platformy zaprojektowane specjalnie dla małych firm, które można wdrożyć bez programisty i bez długiej konfiguracji, a bot uczy się z własnej bazy wiedzy klienta, a nie z ogólnego modelu.
W praktyce liczą się trzy rzeczy: panel analityczny, który pokazuje, na jakie pytania bot nie znajduje odpowiedzi, opcja przejęcia rozmowy przez konsultanta w momencie, gdy temat jest zbyt ryzykowny dla automatu, oraz integracje bez kodu, które ograniczają liczbę miejsc, gdzie dane mogą się rozjechać. Fibly obsługuje czat na stronie, e-mail, WhatsApp, Messenger i Instagram z jednego miejsca, co ułatwia trzymanie się zasady jednego źródła prawdy opisanej wyżej.
Plan Starter kosztuje 149 zł miesięcznie, a Professional 499 zł miesięcznie, oba z limitem kredytów na odpowiedzi AI, który można rozszerzyć dodatkowymi pakietami. Sprawdź pełny cennik albo zacznij od przewodnika szybki start, żeby zobaczyć, jak wygląda konfiguracja bazy wiedzy krok po kroku.
Źródła
- Baza wiedzy do chatbota firmowego — budowa i kontrola (InternetStars)
- Keeping AI chatbot knowledge base updated (FlowHunt)
Najczęściej zadawane pytania
Co robić najpierw, gdy chatbot podaje błędną odpowiedź?
Sprawdź, jaki fragment bazy wiedzy bot zacytował jako źródło odpowiedzi. W większości przypadków to nieaktualny albo sprzeczny dokument, a nie problem samego modelu.
Jak często trzeba przeglądać bazę wiedzy chatbota?
Zależy od zmienności tematu: ceny i promocje warto sprawdzać co tydzień, polityki i regulaminy raz w miesiącu, a treści ogólne co kwartał. Kluczowe jest przypisanie właściciela do każdej z tych kategorii.
Czy PDF-y szkodzą jakości odpowiedzi chatbota?
Tak, PDF-y i skany utrudniają chunkowanie i mogą powodować utratę kontekstu w porównaniu z tekstem w formacie Markdown. Jeśli kluczowa informacja siedzi tylko w PDF-ie, warto ją przepisać do formatu tekstowego przed dodaniem do bazy.
Ile pytań kontrolnych potrzeba do testu regresji?
Zestaw kilkudziesięciu pytań kontrolnych zwykle wystarcza, by wykryć drift po aktualizacji bazy albo modelu. Testy odpalaj po każdej istotnej zmianie treści, nie tylko raz na kwartał.
Ile kosztuje narzędzie takie jak Fibly do zarządzania bazą wiedzy chatbota?
Plan Starter Fibly kosztuje 149 zł miesięcznie, a plan Professional 499 zł miesięcznie, oba z ustalonym limitem kredytów na odpowiedzi AI. Dodatkowe kredyty i stanowiska operatorów można dokupić w ramach tego samego cennika.
Rekomendacje
- Bot daje błędne odpowiedzi
- Chatbot z bazą wiedzy: jak zbudować go krok po kroku
- Dokumentacja chatbota: szablony, checklista i wdrożenie
- 3 rzeczy na start. Testowanie chatbota dla małych firm bez programisty
Ten artykuł został stworzony przy wykorzystaniu AI.